
Bias (độ chệch) trong thống kê đề cập đến sai lệch có hệ thống giữa kết quả ước tính và giá trị thực tế của một tham số. Hiểu rõ bản chất của bias là yếu tố then chốt để đảm bảo tính chính xác và độ tin cậy của mọi phân tích dữ liệu, từ đó đưa ra quyết định sáng suốt hơn. Bài viết này sẽ đi sâu vào định nghĩa, các nguyên nhân phổ biến dẫn đến bias, hậu quả nghiêm trọng mà nó gây ra, cũng như các phương pháp hiệu quả để nhận biết và giảm thiểu bias.
Trong phần nội dung chính, chúng ta sẽ khám phá định nghĩa cốt lõi của bias trong thống kê và vai trò của nó trong phân tích dữ liệu. Tiếp theo, các loại bias thường gặp như thiên lệch chọn mẫu, đo lường, lựa chọn, xác nhận và hồi tưởng sẽ được phân tích chi tiết với các ví dụ minh họa. Phần này cũng sẽ làm rõ hậu quả và tác động tiêu cực của bias lên kết quả thống kê và quá trình ra quyết định. Cuối cùng, bài viết sẽ cung cấp các chiến lược và phương pháp thực tế để nhận biết và giảm thiểu bias.
Phần nội dung bổ sung sẽ đi sâu vào mối quan hệ phức tạp giữa bias, variance và độ chính xác trong học máy, đặc biệt là trong bối cảnh mô hình hóa dữ liệu.
Bias (Độ chệch) trong Thống kê là gì?
Bias, hay độ chệch, trong thống kê là sự sai khác có hệ thống và nhất quán giữa giá trị trung bình của các kết quả ước tính và giá trị thực tế của tham số mà chúng ta đang cố gắng đo lường. Vai trò cốt lõi của khái niệm bias trong thống kê và phân tích dữ liệu nằm ở việc nó cho thấy mức độ sai lệch dự kiến của một phương pháp hoặc mô hình. Nếu một phương pháp có bias cao, các kết quả mà nó tạo ra, dù lặp lại nhiều lần, vẫn sẽ có xu hướng chệch xa so với sự thật.
Sự sai khác có tính hệ thống này có nghĩa là bias không phải là lỗi ngẫu nhiên có thể tự điều chỉnh qua các lần lấy mẫu hoặc quan sát khác nhau. Thay vào đó, nó là một khuynh hướng nhất quán khiến cho ước lượng luôn cao hơn hoặc luôn thấp hơn giá trị thực. Ví dụ, nếu một chiếc cân luôn hiển thị sai số dương 1kg, thì mọi phép đo được thực hiện bằng chiếc cân đó đều sẽ bị bias, bất kể bạn cân vật gì.
Các Nguyên nhân phổ biến dẫn đến Bias trong Thống kê
Có nhiều yếu tố khác nhau có thể dẫn đến bias trong thống kê, và việc nhận diện chúng là bước đầu tiên để khắc phục. Dưới đây là các loại bias thường gặp nhất mà các nhà phân tích dữ liệu và nhà nghiên cứu cần lưu tâm.
Có thể bạn quan tâm: Bianco Là Gì? Giải Mã Ý Nghĩa Và Các Ứng Dụng Phổ Biến
Sampling Bias (Thiên lệch chọn mẫu)
Sampling Bias, hay thiên lệch chọn mẫu, xảy ra khi mẫu được chọn không phản ánh đúng đặc điểm của tổng thể mà nó đại diện. Điều này dẫn đến việc các kết luận rút ra từ mẫu có thể không chính xác khi áp dụng cho toàn bộ quần thể.
Ví dụ, nếu một cuộc khảo sát ý kiến về sản phẩm công nghệ chỉ được thực hiện thông qua các diễn đàn trực tuyến dành cho người dùng cao cấp, mẫu thu thập được có thể quá thiên về nhóm người am hiểu công nghệ và có thu nhập cao. Kết quả khảo sát có thể cho thấy mức độ hài lòng cao hơn nhiều so với thực tế, bởi lẽ nó đã bỏ qua ý kiến của đa số người dùng phổ thông có nhu cầu và trải nghiệm khác biệt.
Measurement Bias (Thiên lệch đo lường)
Measurement Bias, hay thiên lệch đo lường, phát sinh từ sai số hệ thống trong quá trình thu thập dữ liệu, do công cụ đo lường, thang đo, hoặc cách thiết kế câu hỏi chưa chuẩn. Sai số này làm cho dữ liệu thu thập được không phản ánh đúng bản chất của thông tin cần đo lường.
Ví dụ, việc sử dụng thang đo Likert với các tùy chọn “Hoàn toàn đồng ý” đến “Hoàn toàn không đồng ý” có thể gặp phải thiên lệch nếu các câu hỏi được đặt ra theo hướng dẫn người trả lời. Một câu hỏi như “Bạn có đồng ý với chính sách đột phá nhằm cải thiện môi trường làm việc mà công ty chúng ta đang triển khai không?” có xu hướng dẫn người trả lời nghiêng về phía tích cực, thay vì cho phép họ đưa ra ý kiến khách quan về chính sách đó.
Selection Bias (Thiên lệch lựa chọn)
Selection Bias, hay thiên lệch lựa chọn, xảy ra khi có sự khác biệt có hệ thống giữa những đối tượng được chọn vào nghiên cứu và những đối tượng không được chọn, dẫn đến mẫu nghiên cứu không còn tính ngẫu nhiên và đại diện. Khác với Sampling Bias, Selection Bias thường nhấn mạnh vào quy trình lựa chọn đối tượng tham gia nghiên cứu, nơi mà các yếu tố nào đó đã làm thay đổi cơ hội được chọn của các cá nhân.

Có thể bạn quan tâm: Bianca Là Gì? Ý Nghĩa, Nguồn Gốc Tên Gọi Và Người Nổi Tiếng Mang Tên Bianca
Ví dụ, một nghiên cứu về hiệu quả của một chương trình giảm cân có thể chỉ tuyển chọn những người đã từng tham gia các chương trình sức khỏe tương tự. Nhóm này có thể có động lực cao hơn và sự tuân thủ tốt hơn so với dân số nói chung, dẫn đến kết quả nghiên cứu không phản ánh đúng hiệu quả của chương trình đối với mọi người.
Confirmation Bias (Thiên lệch xác nhận)
Confirmation Bias, hay thiên lệch xác nhận, là xu hướng tâm lý tự nhiên của con người là tìm kiếm, diễn giải, ưa chuộng và ghi nhớ thông tin theo cách củng cố hoặc xác nhận những niềm tin, giả thuyết có sẵn của bản thân. Trong thống kê, điều này có thể ảnh hưởng nghiêm trọng đến việc thu thập và phân tích dữ liệu.
Khi các nhà nghiên cứu hoặc nhà phân tích có sẵn một giả thuyết, họ có thể vô thức tập trung vào các bằng chứng ủng hộ giả thuyết đó, bỏ qua hoặc giảm nhẹ tầm quan trọng của các bằng chứng mâu thuẫn. Điều này dẫn đến việc dữ liệu được diễn giải một cách sai lệch, củng cố những kết luận đã được định sẵn thay vì dựa trên bức tranh toàn cảnh của dữ liệu.
Recall Bias (Thiên lệch hồi tưởng)
Recall Bias, hay thiên lệch hồi tưởng, là một dạng sai lệch xảy ra khi các đối tượng tham gia nghiên cứu gặp khó khăn hoặc có sự nhầm lẫn khi cố gắng nhớ lại các sự kiện, trải nghiệm hoặc thông tin từ trong quá khứ. Loại bias này đặc biệt có tác động đến các nghiên cứu hồi cứu, nơi mà dữ liệu được thu thập bằng cách hỏi người tham gia về các sự kiện đã xảy ra.
Ví dụ, trong một nghiên cứu y tế nhằm tìm hiểu mối liên hệ giữa một thói quen cũ và một bệnh mãn tính, những người mắc bệnh có thể có xu hướng nhớ lại hoặc phóng đại các yếu tố nguy cơ trong quá khứ hơn so với những người khỏe mạnh. Điều này là do họ có thể đang tìm kiếm lời giải thích cho tình trạng bệnh tật của mình, dẫn đến sự sai lệch trong dữ liệu được báo cáo.
Hậu quả và Tác động của Bias đối với Kết quả Thống kê
Có thể bạn quan tâm: Bia Úp Ngược Là Gì? Khám Phá Công Thức Pha Chế Độc Đáo & Cách Thưởng Thức Chuẩn
Bias trong thống kê không chỉ là một khái niệm lý thuyết mà còn mang lại những hậu quả thực tế và nghiêm trọng, ảnh hưởng trực tiếp đến độ tin cậy và tính hữu ích của các kết quả phân tích. Khi bias tồn tại, nó sẽ dẫn đến sai lệch kết quả phân tích, ước lượng sai tham số của tổng thể, làm giảm độ chính xác của các phép đo thống kê.
Quan trọng hơn, tác động tiêu cực của bias lên việc ra quyết định dựa trên dữ liệu có thể dẫn đến những sai lầm tốn kém. Khi các nhà lãnh đạo, nhà khoa học, hay doanh nghiệp đưa ra quyết định dựa trên những thông tin bị sai lệch, họ có thể đầu tư sai nguồn lực, phát triển sản phẩm không phù hợp, hoặc thực hiện các chiến lược không hiệu quả.
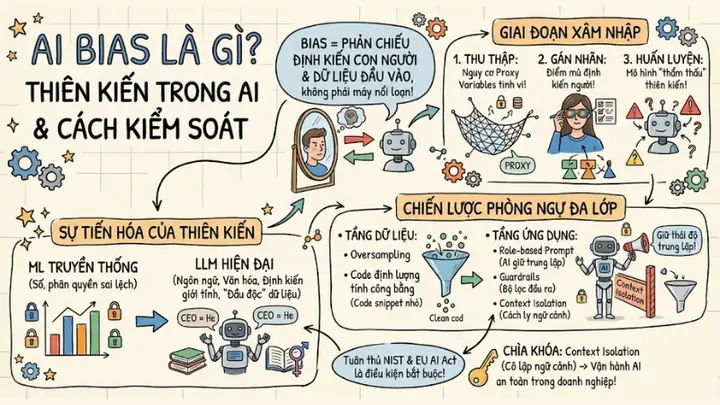
Minh họa với các lĩnh vực cụ thể sẽ cho thấy rõ hơn tác động này. Trong nghiên cứu khoa học, bias có thể dẫn đến các kết luận sai lầm, làm chậm trễ tiến bộ hoặc định hướng sai các nghiên cứu tiếp theo. Trong A/B testing, bias có thể khiến doanh nghiệp tin rằng một phiên bản thay thế tốt hơn phiên bản gốc, trong khi thực tế sự khác biệt là do sai lệch trong cách chọn mẫu hoặc đo lường. Trong lĩnh vực Machine Learning, bias có thể khiến mô hình học máy đưa ra dự đoán không công bằng, thiếu chính xác hoặc không thể khái quát hóa cho dữ liệu mới.
Làm thế nào để Nhận biết và Giảm thiểu Bias?
Việc nhận biết sớm các dấu hiệu của bias và áp dụng các biện pháp phòng ngừa, giảm thiểu là cực kỳ quan trọng để đảm bảo tính toàn vẹn của dữ liệu và kết quả phân tích. Có nhiều phương pháp và chiến lược có thể được áp dụng trong suốt quy trình thu thập, xử lý và phân tích dữ liệu.
Các phương pháp nhận diện dấu hiệu của bias bao gồm việc xem xét kỹ lưỡng quy trình lấy mẫu, đánh giá tính khách quan của công cụ đo lường và câu hỏi khảo sát, cũng như kiểm tra xem có sự khác biệt hệ thống nào giữa các nhóm tham gia nghiên cứu hay không. Đồng thời, việc rà soát lại các giả thuyết ban đầu và tìm kiếm bằng chứng mâu thuẫn có thể giúp phát hiện thiên lệch xác nhận.
Chiến lược giảm thiểu bias tập trung vào việc thiết kế nghiên cứu chặt chẽ và áp dụng các kỹ thuật lấy mẫu ngẫu nhiên, đảm bảo mẫu đại diện cho tổng thể. Kỹ thuật làm sạch dữ liệu, bao gồm việc phát hiện và xử lý các giá trị ngoại lai hoặc các mẫu bất thường, cũng đóng vai trò quan trọng. Việc kiểm định sai lệch bằng cách so sánh kết quả từ các phương pháp khác nhau hoặc sử dụng các nhóm đối chứng cũng giúp đánh giá và điều chỉnh bias.
Có thể bạn quan tâm: Bia Ôm Là Gì? Định Nghĩa, Nguồn Gốc Và Văn Hóa “bia Ôm” Ở Việt Nam
Mối quan hệ giữa Bias, Variance và Độ chính xác trong Học máy
Trong lĩnh vực học máy, việc tối ưu hóa hiệu suất của mô hình không chỉ dừng lại ở việc giảm thiểu sai số tổng thể mà còn đòi hỏi sự hiểu biết sâu sắc về mối quan hệ giữa Bias và Variance, hai yếu tố cốt lõi ảnh hưởng đến độ chính xác của mô hình.
Bias trong Machine Learning: Định nghĩa và Ví dụ
Trong ngữ cảnh học máy, bias đề cập đến các giả định sai lầm hoặc quá đơn giản hóa mà một mô hình đưa ra về mối quan hệ giữa các biến đầu vào và biến đầu ra. Một mô hình có bias cao thường không nắm bắt được sự phức tạp thực sự của dữ liệu, dẫn đến lỗi hệ thống trong dự đoán. Đây còn được gọi là tình trạng underfitting (chưa khớp).
Ví dụ, một mô hình hồi quy tuyến tính được sử dụng để dự đoán giá nhà, trong khi mối quan hệ thực tế giữa diện tích nhà và giá nhà là phi tuyến tính và bị ảnh hưởng bởi nhiều yếu tố khác như vị trí, tiện ích, thì mô hình tuyến tính có thể bị bias cao. Nó sẽ đưa ra những dự đoán sai lệch cho cả những ngôi nhà nhỏ và những ngôi nhà rất lớn.
Variance trong Machine Learning: Định nghĩa và Ví dụ
Variance, hay phương sai, trong học máy chỉ mức độ nhạy cảm của mô hình với những biến động trong dữ liệu huấn luyện. Một mô hình có variance cao sẽ học quá kỹ các đặc điểm và nhiễu trong dữ liệu huấn luyện, dẫn đến việc nó hoạt động rất tốt trên tập dữ liệu đó nhưng lại kém hiệu quả khi áp dụng cho dữ liệu mới. Đây là hiện tượng overfitting (quá khớp).
Ví dụ, một mô hình cây quyết định được huấn luyện trên một tập dữ liệu có nhiễu và nhiều trường hợp ngoại lệ có thể tạo ra một cây rất phức tạp, với nhiều nhánh nhỏ để phân loại chính xác từng điểm dữ liệu huấn luyện. Tuy nhiên, khi gặp dữ liệu mới, cây phức tạp này có thể đưa ra những dự đoán không chính xác do nó đã học cả những đặc điểm không mang tính tổng quát.
Tầm quan trọng của việc cân bằng Bias và Variance
Cả bias cao và variance cao đều dẫn đến kết quả dự đoán kém, mặc dù theo những cách khác nhau. Mô hình có bias cao không đủ linh hoạt để nắm bắt mối quan hệ thực sự trong dữ liệu, trong khi mô hình có variance cao lại quá nhạy cảm với dữ liệu huấn luyện và không khái quát hóa tốt. Mục tiêu là tìm kiếm một sự cân bằng giữa hai yếu tố này để xây dựng mô hình có khả năng dự đoán tốt trên cả dữ liệu đã thấy và dữ liệu chưa thấy.
Các phương pháp phổ biến để quản lý sự đánh đổi này bao gồm việc lựa chọn mô hình phù hợp với độ phức tạp của dữ liệu, sử dụng kỹ thuật điều chuẩn (regularization) để giảm thiểu overfitting, kỹ thuật cross-validation để đánh giá hiệu suất mô hình một cách khách quan, và tăng cường số lượng hoặc chất lượng dữ liệu huấn luyện.
Ví dụ Thực tiễn về Bias trong các lĩnh vực Ứng dụng
Bias có thể xuất hiện và gây ảnh hưởng nghiêm trọng trong nhiều tình huống thực tế, đòi hỏi sự cẩn trọng trong mọi quy trình phân tích dữ liệu.
Trong A/B testing, một ví dụ điển hình là khi việc phân bổ người dùng vào hai nhóm thử nghiệm không được thực hiện ngẫu nhiên và công bằng. Nếu một nhóm có xu hướng là người dùng trung thành hơn, hoặc sử dụng thiết bị mới hơn, thì bất kỳ sự khác biệt nào về tỷ lệ chuyển đổi có thể là do yếu tố thiên lệch này chứ không hẳn là do sự thay đổi trong thiết kế (A/B). Điều này dẫn đến việc đưa ra quyết định sai lầm về việc giữ lại hay loại bỏ thay đổi.
Trong phân tích dữ liệu y tế, bias có thể ảnh hưởng đến các mô hình chẩn đoán bệnh hoặc dự đoán kết quả điều trị. Nếu dữ liệu huấn luyện không đại diện cho sự đa dạng của dân số về chủng tộc, giới tính, hoặc tình trạng kinh tế-xã hội, mô hình có thể hoạt động kém hiệu quả hoặc đưa ra dự đoán thiếu công bằng cho một số nhóm dân số nhất định. Ví dụ, một thuật toán chẩn đoán bệnh tim có thể kém chính xác hơn đối với phụ nữ hoặc người thuộc các nhóm thiểu số nếu dữ liệu huấn luyện chủ yếu dựa trên nam giới da trắng.
Cập Nhật Lúc Tháng 9 24, 2026 by admin



