
Trong kỷ nguyên số bùng nổ, lượng dữ liệu tạo ra ngày càng tăng với tốc độ chóng mặt, đặt ra thách thức lớn cho việc lưu trữ, xử lý và phân tích. Apache Hadoop đã nổi lên như một giải pháp mạnh mẽ, một framework mã nguồn mở tiên phong trong việc quản lý và xử lý dữ liệu lớn (Big Data) một cách hiệu quả và có khả năng mở rộng. Bài viết này sẽ đi sâu vào khái niệm, kiến trúc, cách thức hoạt động và tầm quan trọng không thể phủ nhận của Hadoop trong thế giới công nghệ hiện đại.
Chúng ta sẽ khám phá Hadoop là gì, các thành phần cốt lõi làm nên sức mạnh của nó bao gồm HDFS, MapReduce và YARN. Tiếp theo, bài viết sẽ phân tích cách Hadoop xử lý dữ liệu phân tán, từ đó lý giải tại sao framework này lại trở thành trụ cột trong lĩnh vực dữ liệu lớn, giải quyết những thách thức cốt lõi về khối lượng, tốc độ và sự đa dạng của dữ liệu. Cuối cùng, chúng ta sẽ xem xét mối quan hệ của Hadoop với các công nghệ Big Data khác như Spark và cách nó tích hợp với các dịch vụ đám mây, giúp bạn có cái nhìn toàn diện về vị trí và vai trò của Hadoop trong hệ sinh thái công nghệ ngày nay.
Apache Hadoop Là Gì? Khái Niệm Cơ Bản
Apache Hadoop là một framework mã nguồn mở, được thiết kế để xử lý các tập dữ liệu rất lớn trên một cụm (cluster) gồm nhiều máy tính. Nó đóng vai trò là nền tảng cho việc lưu trữ phân tán và xử lý dữ liệu theo mô hình MapReduce, cho phép các tổ chức quản lý và phân tích hiệu quả khối lượng dữ liệu khổng lồ mà các hệ thống truyền thống không thể đáp ứng. Bản chất là mã nguồn mở, Hadoop mang lại sự linh hoạt, khả năng tùy biến cao và cộng đồng phát triển mạnh mẽ, cho phép nó liên tục được cải tiến và áp dụng rộng rãi.
Hadoop được tạo ra bởi Doug Cutting và Mike Cafarella vào năm 2005, lấy cảm hứng từ kiến trúc Google File System (GFS) và MapReduce. Mục tiêu ban đầu của Hadoop là xây dựng một hệ thống có thể lưu trữ và xử lý dữ liệu lớn một cách đáng tin cậy, có khả năng chịu lỗi và mở rộng dễ dàng trên phần cứng thông thường, với chi phí hợp lý. Cái tên “Hadoop” được đặt theo tên một món đồ chơi voi nhồi bông của con trai Doug Cutting, thể hiện sự đơn giản và mạnh mẽ mà framework này hướng tới.
Các Thành Phần Cốt Lõi Của Apache Hadoop
Sức mạnh của Apache Hadoop nằm ở các thành phần cốt lõi, mỗi thành phần đóng một vai trò quan trọng trong việc xây dựng một hệ thống xử lý dữ liệu lớn toàn diện. Ba thành phần chính bao gồm Hadoop Distributed File System (HDFS), Hadoop MapReduce và Hadoop YARN, cùng với Hadoop Common cung cấp các tiện ích hỗ trợ.
Hadoop Distributed File System (HDFS)
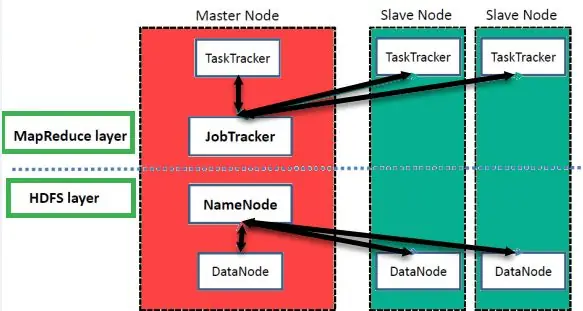
Hadoop Distributed File System (HDFS) là hệ thống lưu trữ phân tán, chịu lỗi và có khả năng mở rộng cao, đóng vai trò là lớp lưu trữ chính của Hadoop. HDFS lưu trữ các tập tin dữ liệu lớn bằng cách chia chúng thành nhiều khối (block) và phân tán các khối này trên các nút (node) khác nhau trong cụm. Điều này không chỉ giúp tận dụng sức mạnh lưu trữ của nhiều máy mà còn đảm bảo tính sẵn sàng cao (high availability) và khả năng phục hồi khi có lỗi xảy ra trên một hoặc nhiều nút.
Có thể bạn quan tâm: Apache Flink Là Gì? Khám Phá Nền Tảng Xử Lý Dữ Liệu Thời Gian Thực Mạnh Mẽ
Chức năng cốt lõi của HDFS là lưu trữ dữ liệu một cách đáng tin cậy, ngay cả khi có các phần cứng bị lỗi. Nó cung cấp một giao diện truy cập file system tương tự như các hệ thống file truyền thống nhưng được thiết kế cho môi trường phân tán. Dữ liệu trong HDFS thường được sao chép (replication) sang nhiều nút khác nhau để đảm bảo không bị mất mát khi một nút gặp sự cố.
Hadoop MapReduce
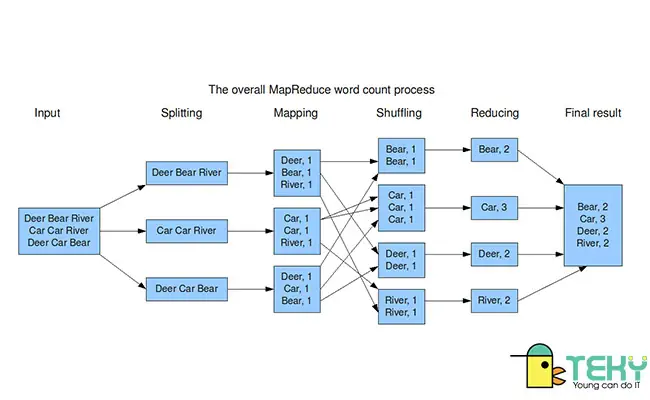
Hadoop MapReduce là mô hình lập trình và là một framework xử lý dữ liệu song song. Nó cho phép xử lý các tập dữ liệu lớn trên các máy tính trong cụm một cách hiệu quả. Quá trình xử lý MapReduce bao gồm hai giai đoạn chính: Map và Reduce. Giai đoạn Map nhận dữ liệu đầu vào, xử lý nó thành các cặp khóa-giá trị (key-value pairs) trung gian. Giai đoạn Reduce sau đó nhận các cặp này, nhóm chúng lại dựa trên khóa và thực hiện các phép tổng hợp hoặc biến đổi cuối cùng để tạo ra kết quả.
MapReduce giúp đơn giản hóa việc phát triển các ứng dụng xử lý dữ liệu lớn bằng cách trừu tượng hóa sự phức tạp của việc phân tán, xử lý song song và quản lý lỗi trên một cụm máy tính. Nó là một trong những nền tảng đầu tiên giúp các nhà phát triển dễ dàng khai thác sức mạnh của Big Data.
Hadoop YARN
Hadoop YARN (Yet Another Resource Negotiator) là một hệ thống quản lý tài nguyên và lập lịch tác vụ (task scheduler) cho các ứng dụng chạy trên Hadoop. YARN đóng vai trò như hệ điều hành của cụm Hadoop, chịu trách nhiệm quản lý tài nguyên tính toán (CPU, bộ nhớ) của các máy chủ trong cụm và phân bổ chúng cho các ứng dụng khác nhau. Nó cho phép nhiều loại ứng dụng xử lý dữ liệu (ngoài MapReduce) có thể chạy trên cùng một cụm Hadoop, làm tăng tính linh hoạt và hiệu quả sử dụng tài nguyên.
YARN bao gồm hai thành phần chính: ResourceManager (quản lý tài nguyên tổng thể của cụm) và NodeManager (quản lý tài nguyên trên từng nút và giám sát các container ứng dụng). YARN đã tách biệt quá trình quản lý tài nguyên khỏi các ứng dụng xử lý dữ liệu, mở đường cho sự phát triển của các framework xử lý mới như Spark, Flink,… trên nền tảng Hadoop.
Hadoop Common

Có thể bạn quan tâm: Apache Cordova Là Gì? Hướng Dẫn Chi Tiết Cho Người Mới Bắt Đầu
Hadoop Common là tập hợp các thư viện, tiện ích và các thành phần cơ bản cung cấp các dịch vụ chung cho các module khác của Hadoop. Nó bao gồm các API Java, các công cụ dòng lệnh (command-line tools), và các dịch vụ cần thiết để hỗ trợ hoạt động của HDFS, MapReduce và YARN. Ví dụ, Hadoop Common cung cấp các thành phần để xử lý các định dạng file, quản lý cấu hình, xử lý ghi log, và các tiện ích mạng.
Các thư viện trong Hadoop Common là nền tảng cho phép các thành phần khác của Hadoop hoạt động một cách hiệu quả và nhất quán. Chúng cung cấp các chức năng cơ bản như khởi tạo, cấu hình và tương tác giữa các tiến trình trong một môi trường phân tán.
Cách Thức Hoạt Động Của Apache Hadoop
Để hiểu rõ cách Apache Hadoop xử lý dữ liệu lớn, chúng ta cần phân tích quy trình hoạt động của nó, từ cách dữ liệu được lưu trữ đến cách chúng được xử lý song song. Quá trình này dựa trên sự phối hợp nhịp nhàng giữa HDFS, MapReduce và YARN.
Quy trình xử lý dữ liệu lớn trong Hadoop thường bắt đầu bằng việc đưa dữ liệu vào HDFS. Dữ liệu này, có thể là các file văn bản, hình ảnh, video hoặc bất kỳ định dạng nào, sẽ được chia thành các khối có kích thước cố định (thường là 128MB hoặc 256MB). Các khối này sau đó được phân tán và sao chép sang nhiều DataNode khác nhau trong cụm. HDFS NameNode chịu trách nhiệm quản lý metadata của hệ thống file, bao gồm tên file, số lượng khối, vị trí của từng khối trên các DataNode, nhưng nó không lưu trữ dữ liệu thực tế. Cơ chế sao chép này đảm bảo rằng nếu một DataNode bị lỗi, dữ liệu vẫn có sẵn trên các DataNode khác.
Khi một ứng dụng Hadoop cần xử lý dữ liệu, YARN sẽ đóng vai trò điều phối. ResourceManager sẽ cấp phát tài nguyên cần thiết (như CPU, bộ nhớ) cho ứng dụng, và ApplicationMaster của ứng dụng sẽ làm việc với NodeManager trên từng DataNode để thực thi các tác vụ. Nếu sử dụng MapReduce, quá trình này bao gồm các giai đoạn Map và Reduce. Các tác vụ Map được phân phối đến các DataNode chứa các khối dữ liệu liên quan để xử lý cục bộ, giảm thiểu việc truyền dữ liệu qua mạng. Sau khi giai đoạn Map hoàn thành, kết quả trung gian sẽ được sắp xếp và nhóm lại (shuffle and sort) trước khi chuyển sang giai đoạn Reduce. Các tác vụ Reduce sẽ nhận dữ liệu đã được nhóm và thực hiện các phép tính cuối cùng để tạo ra kết quả tổng hợp. Toàn bộ quá trình này được YARN giám sát và quản lý để đảm bảo hiệu suất và độ tin cậy.
Cơ chế phân tán và song song hóa là cốt lõi của cách Hadoop hoạt động. Thay vì xử lý dữ liệu trên một máy chủ duy nhất, Hadoop chia nhỏ dữ liệu và công việc xử lý cho nhiều máy. Điều này cho phép xử lý đồng thời nhiều phần của tập dữ liệu lớn, rút ngắn đáng kể thời gian xử lý so với các phương pháp truyền thống. Khả năng chịu lỗi được tích hợp sâu sắc thông qua cơ chế sao chép dữ liệu trong HDFS và khả năng khởi động lại các tác vụ bị lỗi của YARN, đảm bảo rằng một sự cố trên một vài máy không làm gián đoạn toàn bộ quá trình xử lý.
Tại Sao Apache Hadoop Lại Quan Trọng Trong Thế Giới Big Data?
Có thể bạn quan tâm: Kem Đánh Răng Ap24 Là Gì? Công Dụng, Các Loại Và Cách Dùng Hiệu Quả
Apache Hadoop đóng vai trò cực kỳ quan trọng trong thế giới Big Data nhờ vào những ưu điểm vượt trội và khả năng giải quyết hiệu quả các thách thức cố hữu của dữ liệu lớn. Framework này đã trở thành một trụ cột, cho phép các doanh nghiệp khai thác giá trị từ lượng dữ liệu ngày càng tăng của họ.
Ưu Điểm Của Hadoop
Hadoop mang lại nhiều lợi ích quan trọng cho việc xử lý dữ liệu lớn:
- Khả năng mở rộng (Scalability): Hadoop có thể mở rộng quy mô xử lý và lưu trữ bằng cách thêm nhiều máy chủ vào cụm. Điều này cho phép nó xử lý các tập dữ liệu ngày càng lớn hơn mà không gặp phải giới hạn về hiệu suất.
- Tính linh hoạt (Flexibility): Hadoop có thể xử lý nhiều loại dữ liệu khác nhau, bao gồm dữ liệu có cấu trúc (structured), bán cấu trúc (semi-structured) và phi cấu trúc (unstructured) như văn bản, hình ảnh, âm thanh, video, log file,…
- Chi phí hiệu quả (Cost-Effectiveness): Hadoop được thiết kế để chạy trên phần cứng commodity (phần cứng thông thường, giá rẻ), giúp giảm đáng kể chi phí so với việc sử dụng các hệ thống lưu trữ và xử lý chuyên dụng, đắt tiền.
- Khả năng chịu lỗi (Fault Tolerance): HDFS tự động sao chép dữ liệu trên nhiều nút, và YARN có thể khởi động lại các tác vụ bị lỗi. Điều này đảm bảo rằng hệ thống vẫn hoạt động ngay cả khi có một số lỗi phần cứng xảy ra.
- Xử lý dữ liệu tại chỗ (Data Locality): MapReduce ưu tiên xử lý dữ liệu trên các nút nơi dữ liệu được lưu trữ, giảm thiểu việc di chuyển dữ liệu qua mạng, từ đó tăng tốc độ xử lý.
Giải Quyết Thách Thức Của Dữ Liệu Lớn
Dữ liệu lớn thường được mô tả bằng 3V: Volume (Khối lượng), Velocity (Tốc độ) và Variety (Đa dạng). Apache Hadoop giải quyết những thách thức này như sau:
- Khối lượng (Volume): Với khả năng mở rộng không giới hạn trên các cụm máy tính, Hadoop có thể lưu trữ và xử lý petabyte hoặc thậm chí exabyte dữ liệu, vượt xa khả năng của các hệ thống cơ sở dữ liệu truyền thống.
- Tốc độ (Velocity): Mặc dù Hadoop truyền thống (MapReduce) không phải là nhanh nhất cho các tác vụ thời gian thực, nó cung cấp một nền tảng mạnh mẽ cho việc xử lý theo lô (batch processing) các luồng dữ liệu lớn. Sự ra đời của các công nghệ tích hợp với Hadoop như Spark đã cải thiện đáng kể tốc độ xử lý.
- Đa dạng (Variety): Như đã đề cập, Hadoop có thể xử lý mọi loại dữ liệu, từ dữ liệu có cấu trúc trong các bảng đến dữ liệu phi cấu trúc như nội dung mạng xã hội, video hay file log, giúp khai thác thông tin từ nhiều nguồn khác nhau.
Các Trường Hợp Ứng Dụng Điển Hình
Hadoop đã được áp dụng rộng rãi trong nhiều ngành công nghiệp để giải quyết các bài toán kinh doanh phức tạp:
- Bán lẻ và Thương mại điện tử: Phân tích hành vi khách hàng, cá nhân hóa trải nghiệm mua sắm, tối ưu hóa chuỗi cung ứng, dự đoán xu hướng thị trường.
- Tài chính và Ngân hàng: Phát hiện gian lận, quản lý rủi ro, phân tích thị trường chứng khoán, phân tích tín dụng.
- Viễn thông: Phân tích dữ liệu cuộc gọi (CDR), tối ưu hóa mạng lưới, cá nhân hóa dịch vụ khách hàng.
- Y tế: Phân tích hồ sơ bệnh án điện tử, nghiên cứu dịch tễ học, phát triển thuốc.
- Tìm kiếm và Mạng xã hội: Lập chỉ mục web, phân tích nội dung người dùng, đề xuất nội dung.
- Công nghiệp và Sản xuất: Phân tích dữ liệu cảm biến từ máy móc để dự đoán bảo trì (predictive maintenance), tối ưu hóa quy trình sản xuất.
Mối Quan Hệ Giữa Hadoop, Spark Và Các Công Nghệ Big Data Khác
Hadoop không hoạt động đơn lẻ mà là một phần của một hệ sinh thái Big Data rộng lớn, nơi nó tương tác và tích hợp với nhiều công nghệ khác. Một trong những mối quan hệ đáng chú ý nhất là với Apache Spark.
Có thể bạn quan tâm: Ap Wifi Là Gì? Chức Năng, Nguyên Lý Hoạt Động Và Phân Biệt Với Router
Hadoop và Spark: Sự Khác Biệt và Tương Đồng
Cả Hadoop và Apache Spark đều là các framework mã nguồn mở được sử dụng rộng rãi để xử lý dữ liệu lớn. Điểm tương đồng lớn nhất là cả hai đều được thiết kế để xử lý dữ liệu trên các cụm máy tính và có khả năng mở rộng cao.
Tuy nhiên, chúng khác nhau đáng kể về cách thức hoạt động và hiệu suất:
- Xử lý dữ liệu: Hadoop MapReduce xử lý dữ liệu theo từng giai đoạn, ghi kết quả trung gian ra đĩa (disk-based processing). Điều này làm cho nó chậm hơn đối với các tác vụ yêu cầu xử lý lặp đi lặp lại hoặc truy vấn tương tác. Apache Spark, mặt khác, xử lý dữ liệu trong bộ nhớ (in-memory processing), giúp nó nhanh hơn đáng kể (lên đến 100 lần cho các tác vụ nhất định) so với MapReduce.
- Mô hình lập trình: MapReduce có mô hình lập trình tương đối đơn giản nhưng đôi khi cứng nhắc. Spark cung cấp các API linh hoạt hơn cho nhiều ngôn ngữ lập trình (Scala, Java, Python, R) và hỗ trợ các mô hình xử lý khác nhau như xử lý theo lô, xử lý tương tác (interactive queries), xử lý luồng (stream processing) và học máy (machine learning).
- Thành phần: Hadoop bao gồm cả lớp lưu trữ (HDFS) và lớp xử lý (MapReduce/YARN). Spark chủ yếu tập trung vào lớp xử lý và thường sử dụng HDFS hoặc các hệ thống lưu trữ khác (như S3, Cassandra) để lưu trữ dữ liệu.
Sự khác biệt này dẫn đến việc Spark thường được xem là “bộ xử lý nhanh hơn” cho nhiều tác vụ Big Data, trong khi HDFS vẫn là lựa chọn lưu trữ phân tán phổ biến và đáng tin cậy. Nhiều triển khai Big Data hiện đại kết hợp cả hai: sử dụng HDFS để lưu trữ dữ liệu và Spark để xử lý dữ liệu đó một cách hiệu quả.
Hadoop Tích Hợp Với Các Công Cụ Khác Trong Hệ Sinh Thái Big Data
Hadoop là trung tâm của một hệ sinh thái công nghệ phát triển mạnh mẽ. Ngoài Spark, nó còn tích hợp với nhiều công cụ khác:
- Apache Hive: Cung cấp một ngôn ngữ truy vấn giống SQL (HiveQL) để truy vấn dữ liệu được lưu trữ trong HDFS, giúp các nhà phân tích dữ liệu quen thuộc với SQL dễ dàng làm việc với Big Data.
- Apache Pig: Một nền tảng và ngôn ngữ kịch bản (Pig Latin) để phân tích các tập dữ liệu lớn, cung cấp một lớp trừu tượng hóa cao hơn so với MapReduce.
- Apache HBase: Một cơ sở dữ liệu NoSQL phân tán, có khả năng mở rộng cao, chạy trên HDFS, cung cấp khả năng truy cập dữ liệu theo thời gian thực.
- Apache Kafka: Một nền tảng streaming phân tán, thường được sử dụng để thu thập và xử lý dữ liệu thời gian thực, sau đó có thể lưu trữ vào HDFS hoặc xử lý bằng Spark.
- Công cụ trực quan hóa dữ liệu: Các công cụ như Tableau, Power BI, Superset có thể kết nối với các nguồn dữ liệu được quản lý bởi Hadoop (thông qua Hive hoặc các API khác) để tạo báo cáo và dashboard.
Các Định Dạng File Phổ Biến Mà Hadoop Hỗ Trợ
Để tối ưu hóa việc lưu trữ và truy vấn dữ liệu trong môi trường phân tán, Hadoop hỗ trợ nhiều định dạng file hiệu quả:
- Text Files: Các định dạng đơn giản như CSV, TSV, JSON. Dễ đọc và viết nhưng kém hiệu quả về không gian lưu trữ và tốc độ truy vấn.
- SequenceFile: Định dạng file nhị phân của Hadoop, lưu trữ các cặp khóa-giá trị.
- Avro: Một định dạng file dựa trên schema, cung cấp khả năng tuần tự hóa và có thể nén dữ liệu tốt. Nó rất linh hoạt khi schema thay đổi.
- Parquet: Một định dạng file cột (columnar storage format) hiệu quả, được tối ưu hóa cho việc truy vấn. Nó nén dữ liệu tốt và cho phép đọc chỉ những cột cần thiết, cải thiện đáng kể hiệu suất truy vấn.
- ORC (Optimized Row Columnar): Tương tự như Parquet, ORC là một định dạng lưu trữ cột, được phát triển bởi Apache Hive. Nó cung cấp hiệu suất đọc/ghi và nén dữ liệu rất tốt, đặc biệt phù hợp với các tác vụ phân tích trên Hive.
Việc lựa chọn định dạng file phù hợp phụ thuộc vào loại dữ liệu, cách thức truy cập và yêu cầu về hiệu suất. Các định dạng như Parquet và ORC thường được ưu tiên cho các tập dữ liệu lớn cần phân tích chuyên sâu do hiệu quả về không gian và tốc độ truy vấn.

Hadoop và Spark: Lựa Chọn Nào Phù Hợp?
Việc lựa chọn giữa Hadoop (cụ thể là MapReduce) và Spark không phải là “cái này hoặc cái kia” mà phụ thuộc vào yêu cầu cụ thể của bài toán:
Apache Hadoop (MapReduce):
- Điểm mạnh: Phù hợp cho các tác vụ xử lý theo lô lớn (large-batch processing) nơi hiệu suất không phải là yếu tố quan trọng nhất, và chi phí là ưu tiên hàng đầu. Đơn giản hơn để hiểu và triển khai ban đầu cho các tác vụ xử lý dữ liệu tuần tự. Khả năng chịu lỗi và phục hồi rất mạnh mẽ.
- Điểm yếu: Chậm hơn đáng kể so với Spark do ghi dữ liệu ra đĩa giữa các bước xử lý. Ít linh hoạt hơn cho các tác vụ tương tác, thời gian thực hoặc học máy.
- Trường hợp sử dụng tối ưu: Xử lý hàng loạt dữ liệu không yêu cầu phản hồi tức thời, lưu trữ dữ liệu lớn trên HDFS, các tác vụ ETL (Extract, Transform, Load) truyền thống.
Apache Spark:
- Điểm mạnh: Rất nhanh do xử lý dữ liệu trong bộ nhớ. Linh hoạt với nhiều mô hình xử lý (batch, stream, SQL, ML, graph). Cung cấp API cho nhiều ngôn ngữ lập trình phổ biến.
- Điểm yếu: Yêu cầu nhiều bộ nhớ (RAM) hơn để hoạt động hiệu quả, có thể làm tăng chi phí phần cứng. Quản lý bộ nhớ phức tạp hơn.
- Trường hợp sử dụng tối ưu: Phân tích dữ liệu tương tác, xử lý dữ liệu thời gian thực (streaming), các tác vụ học máy phức tạp, các ứng dụng yêu cầu hiệu suất cao và độ trễ thấp.
Trong thực tế, nhiều tổ chức sử dụng kết hợp cả hai: HDFS làm hệ thống lưu trữ phân tán, YARN làm trình quản lý tài nguyên, và Spark làm công cụ xử lý dữ liệu chính. Spark có thể đọc dữ liệu từ HDFS và sử dụng YARN để quản lý các tài nguyên tính toán cho các job Spark.
Hadoop Hoạt Động Như Thế Nào Với Các Dịch Vụ Đám Mây?
Ngày nay, Apache Hadoop và các công nghệ liên quan đã được tích hợp sâu vào các dịch vụ đám mây, mang lại sự linh hoạt, khả năng mở rộng và quản lý dễ dàng hơn cho người dùng. Các nhà cung cấp đám mây lớn như Amazon Web Services (AWS), Microsoft Azure và Google Cloud Platform (GCP) đều cung cấp các dịch vụ quản lý Hadoop hoặc các dịch vụ tương tự.
- Amazon Web Services (AWS): AWS cung cấp Amazon EMR (Elastic MapReduce), một dịch vụ quản lý hoàn toàn cho phép bạn triển khai và quản lý các cụm Hadoop, Spark, Hive, Presto và các framework Big Data khác. EMR tự động hóa việc thiết lập, cấu hình và vận hành các cụm, cho phép bạn tập trung vào việc phân tích dữ liệu. Dữ liệu thường được lưu trữ trên Amazon S3 (Simple Storage Service), dịch vụ lưu trữ đối tượng có khả năng mở rộng và bền vững cao, tương tự như HDFS về mặt chức năng.
- Microsoft Azure: Azure cung cấp Azure HDInsight, một dịch vụ đám mây được quản lý đầy đủ, cho phép bạn triển khai các phiên bản mã nguồn mở phổ biến của Hadoop, Spark, Hive, HBase, Storm và Kafka. HDInsight tích hợp chặt chẽ với Azure Data Lake Storage Gen2, một giải pháp lưu trữ đám mây được tối ưu hóa cho Big Data.
- Google Cloud Platform (GCP): GCP cung cấp Cloud Dataproc, một dịch vụ nhanh chóng, dễ sử dụng để chạy các cụm Spark và Hadoop. Dataproc được thiết kế để tích hợp liền mạch với các dịch vụ khác của GCP như Cloud Storage (tương tự S3 và Azure Data Lake Storage) cho việc lưu trữ dữ liệu.
Sử dụng Hadoop trên đám mây mang lại nhiều lợi ích:
Quản lý đơn giản: Các nhà cung cấp đám mây chịu trách nhiệm quản lý cơ sở hạ tầng, giúp giảm gánh nặng vận hành.
Khả năng mở rộng linh hoạt: Dễ dàng tăng hoặc giảm quy mô cụm tùy theo nhu cầu xử lý.
Mô hình thanh toán theo mức sử dụng: Chỉ trả tiền cho tài nguyên thực tế sử dụng.
Tích hợp với các dịch vụ khác: Dễ dàng kết nối với các dịch vụ lưu trữ, cơ sở dữ liệu, công cụ BI và AI/ML trên cùng nền tảng đám mây.
Điều này cho phép các tổ chức, từ startup đến doanh nghiệp lớn, dễ dàng tiếp cận và khai thác sức mạnh của công nghệ xử lý dữ liệu lớn mà không cần đầu tư ban đầu lớn vào phần cứng và chuyên môn vận hành.
Cập Nhật Lúc Tháng 9 23, 2026 by admin



